
Text to Speech
- Tempo
- 2–3 h
- Nível
- Iniciante
- Teste rápido
- ~5 min
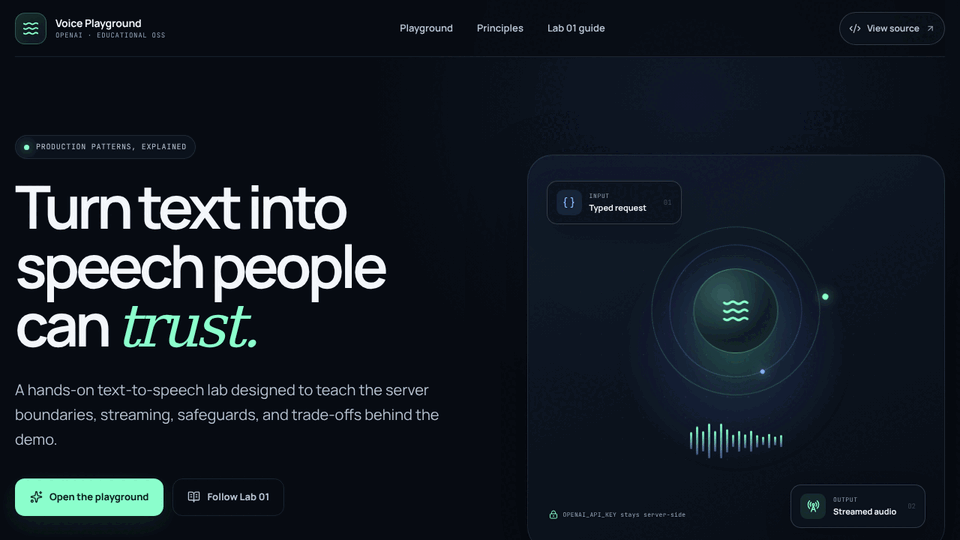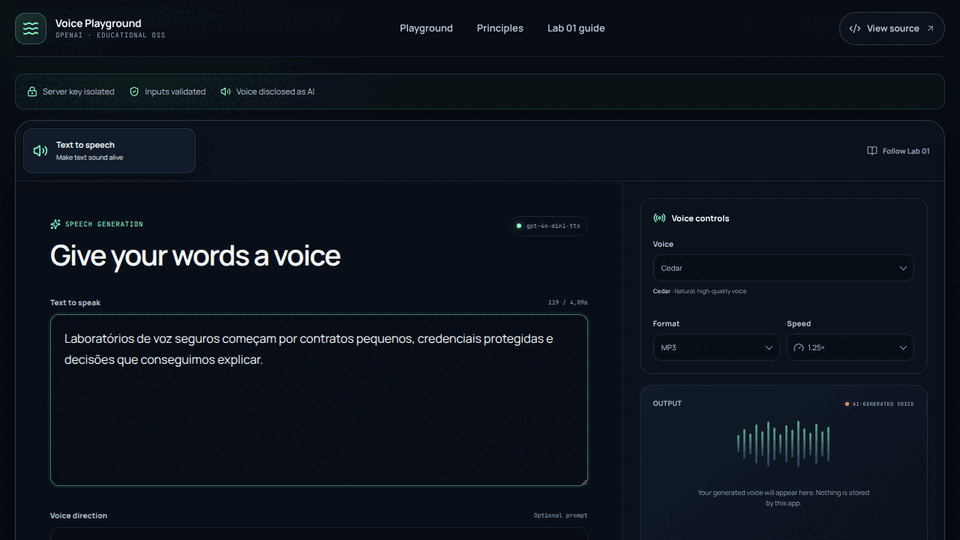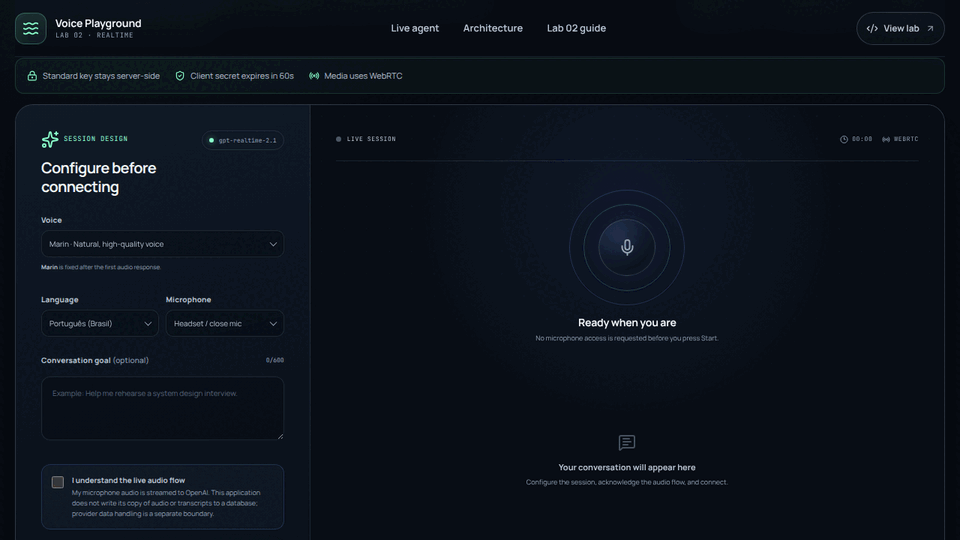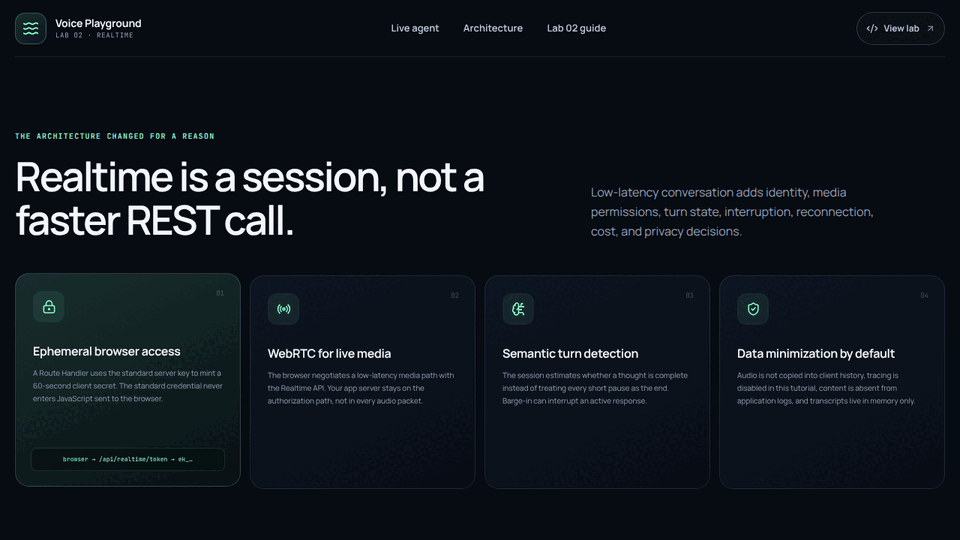
Gere, reproduza e baixe áudio sem enviar a chave ao navegador.
Executar ou construirAprenda passo a passo — do terminal ao deploy. Cada arquivo está completo, cada checkpoint pode ser validado e cada decisão de arquitetura tem um motivo.
O início rápido pressupõe Node.js 22+, Git, uma conta da API OpenAI com cobrança ativa e uma API key criada. As chamadas de voz podem gerar custo.
Gere, reproduza e baixe áudio sem enviar a chave ao navegador.
Executar ou construirConverse por WebRTC usando um segredo temporário e controles explícitos de microfone.
Executar ou construirComece com uma requisição delimitada de áudio e avance para uma conversa de voz em tempo real.
Transforme texto validado em áudio expressivo com streaming, player, download, limites e uma fronteira segura no servidor.
Construa um agente de voz com autorização curta, WebRTC, turnos, mudo, interrupção, transcrição e encerramento seguro.
A demonstração do Lab 01 é real e está comprimida. A gravação do Lab 02 está explicitamente pendente; nenhum resultado foi fabricado.
O espaço está pronto, mas uma conversa em tempo real exige credencial, microfone e consumo da API. Veja o roteiro seguro para gravar sem expor tokens.
Abrir roteiro de gravação →O resultado é o mesmo. O nível de apoio mecânico muda conforme sua experiência e o tempo disponível.
Execute a main, veja a experiência completa e use o código para investigação.
Caminho recomendado: base compilável, implementação por etapas e checkpoints somente para consulta.
Crie configuração, pastas e cada arquivo manualmente para uma aula longa ou estudo aprofundado.
O GitHub Pages hospeda este material estático. As aplicações usam rotas no servidor e variáveis protegidas; publique cada laboratório na Vercel ou em outro host compatível com Next.js.
Ver guia de publicação