
🎙️ OpenAI Voice Labs
Workshops open source para construir experiências de voz com padrão de produção
Aprenda OpenAI Voice, TTS, Realtime, WebRTC e Agents SDK construindo aplicações completas — com segurança, acessibilidade, testes e decisões de arquitetura explicadas.
English · Trilha de workshop · Como acompanhar · Site da documentação · Laboratórios · Executar · Deploy · Sobre






Projeto educacional independente. Não é um produto oficial da OpenAI.
✨ Veja os laboratórios em ação
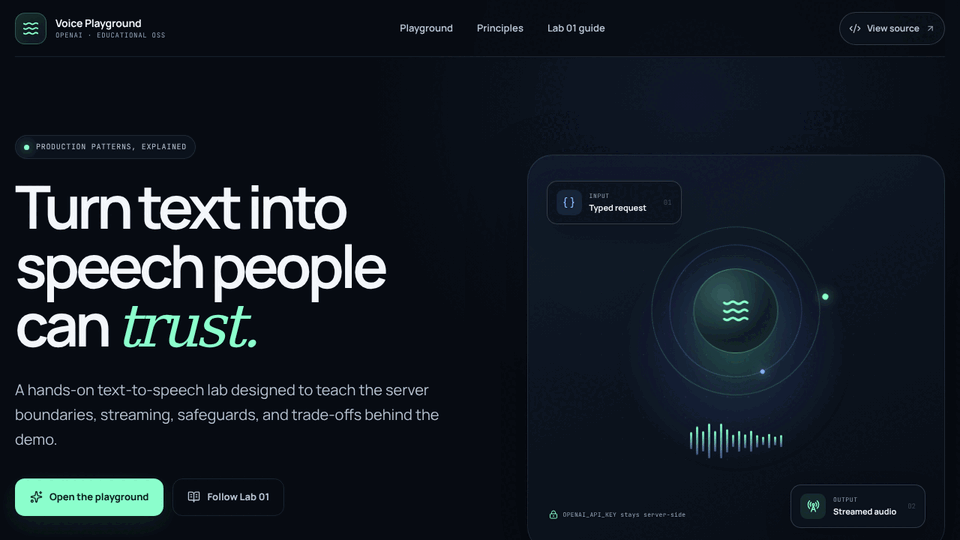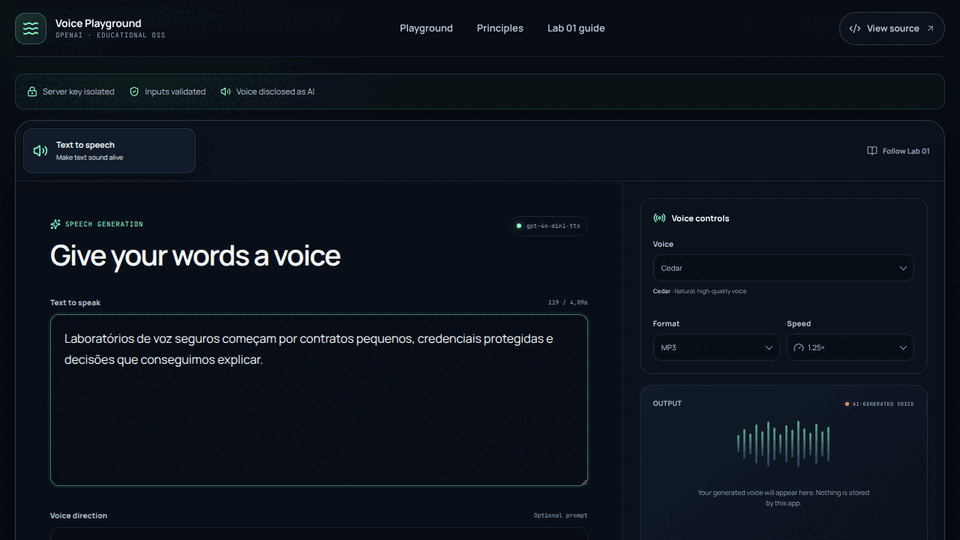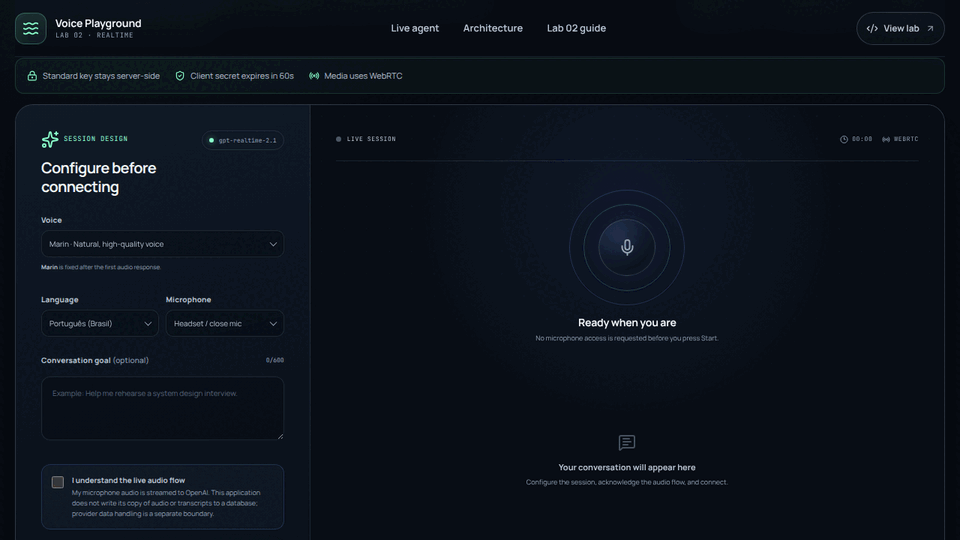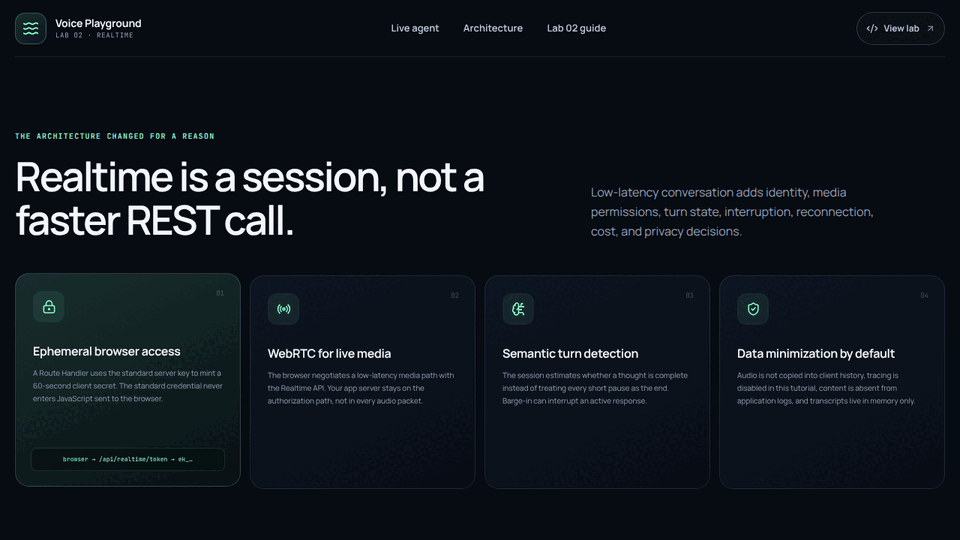
Captura real dos front-ends dos Labs 01 e 02. Nenhuma chamada à API foi realizada durante a gravação.
🧭 Sumário
- Por que este repositório existe
- Trilha de workshop
- Laboratórios
- Arquitetura do repositório
- Pré-requisitos
- Início rápido
- Resumo de execução
- Variáveis de ambiente
- Qualidade e CI/CD
- Deploy na Vercel
- Uso responsável
- Como contribuir
- Sobre a autora
💡 Por que este repositório existe
Uma chamada de voz pode caber em poucas linhas. Uma aplicação confiável exige muito mais.
O OpenAI Voice Labs é uma coleção incremental de workshops para engenheiros que desejam entender não apenas qual endpoint chamar, mas como estruturar uma solução que possa ser explicada, testada, publicada e evoluída por um time real.
Cada laboratório inclui:
- aplicação Next.js completa e independente;
- API Routes para proteger a chave padrão da OpenAI;
- contratos estritos, validação com Zod e erros sanitizados;
- interface responsiva, acessível e com estados de operação explícitos;
- testes sem chamadas pagas à OpenAI;
- CI/CD, instruções de deploy e fronteiras de produção documentadas;
- workshops autossuficientes em português e inglês, começando numa pasta vazia;
- decisões, trade-offs, armadilhas e exercícios de evolução.
🧭 Trilha de workshop
Se esta é sua primeira experiência com a API da OpenAI ou com o repositório, comece pelo índice do workshop. A trilha segue a mesma ideia incremental de workshops práticos de engenharia: preparar o ambiente uma única vez, concluir um módulo delimitado, comprovar o checkpoint e só então avançar.
| Módulo | Comece aqui | Resultado |
|---|---|---|
| 00 — Ambiente e API | Guia de configuração | Ferramentas, projeto da API OpenAI, segredo local, health check e gate de qualidade validados |
| 01 — Text to Speech | Workshop de TTS | Aplicação de geração de fala delimitada, com streaming e proteções |
| 02 — Agente de voz Realtime | Workshop Realtime | Conversa ao vivo por WebRTC, com estados de sessão e segurança explícitos |
Você pode executar a solução pronta, partir de um starter compilável — caminho recomendado — ou reconstruir cada aplicação a partir de uma pasta vazia. O guia de acompanhamento explica checkpoints, comparação e recuperação sem apagar seu trabalho. O restante deste README continua sendo a referência operacional resumida.
Os workshops estão preparados para um site bilíngue no GitHub Pages. Pages hospeda o material estático; as aplicações Next.js continuam em deploy separado porque suas rotas de servidor precisam de credenciais protegidas.
🧪 Laboratórios
| Laboratório | O que você constrói | Modelo e transporte | Tutorial | Estado |
|---|---|---|---|---|
| Lab 01 — Text to Speech | Interface acessível que transforma texto em áudio expressivo, com player e download | gpt-4o-mini-tts · HTTP · áudio em streaming |
Português · English · Starter | ✅ |
| Lab 02 — Agente de Voz Realtime | Agente speech-to-speech fluido, com turnos semânticos, mute, interrupção e alternativa por texto | gpt-realtime-2.1 · WebRTC · Agents SDK |
Português · English · Starter | ✅ |
Lab 01 — Text to Speech
Você aprende a tratar TTS como uma requisição delimitada, manter a credencial no servidor, validar um contrato pequeno e encaminhar o stream de áudio sem acumular o arquivo inteiro na Route Handler.
Principais tópicos: streaming, cancelamento, vozes, instruções de entrega, formatos, velocidade, player, download, disclosure de IA, quotas e erros acessíveis.
Lab 02 — Agente de Voz Realtime
Você aprende por que uma conversa ao vivo é uma sessão com estado e como separar o caminho de autorização do caminho de mídia. O servidor cria um client secret curto; o navegador negocia WebRTC com a OpenAI sem receber a chave padrão.
Principais tópicos: Realtime, Agents SDK, WebRTC, client secret efêmero, semantic VAD, barge-in, mute, transcripts em memória, consentimento e cleanup.
🏗️ Arquitetura do repositório
openai-voice-playground/
├── labs/
│   ├── lab-01-text-to-speech/
│   │   ├── src/                  # aplicação TTS
│   │   ├── tests/                # contratos e proteções
│   │   └── tutorial/
│   │       ├── tutorial.md       # português: do zero ao deploy
│   │       └── tutorial-en.md    # inglês: versão autossuficiente
│   └── lab-02-realtime-voice-agent/
│       ├── src/                  # agente Realtime
│       ├── tests/                # sessão, schemas e proteções
│       └── tutorial/
│           ├── tutorial.md       # português: do zero ao deploy
│           └── tutorial-en.md    # inglês: versão autossuficiente
├── docs/
│   ├── README.md                 # índice e trilhas do workshop
│   ├── 00-configuracao-do-ambiente.md
│   ├── workshop-guide.md         # fluxo starter/checkpoint em inglês
│   ├── workshop-guide-pt-br.md   # fluxo starter/checkpoint em português
│   └── assets/                   # mídia da documentação
├── .github/workflows/ci.yml      # matriz de CI dos laboratórios
├── AGENTS.md                     # regras duráveis para humanos e Codex
└── package.json                  # comandos de orquestração
Os laboratórios possuem package.json e package-lock.json próprios. Essa independência é intencional: cada workshop pode ser instalado, ensinado, testado e publicado sem depender do runtime do outro.
A main permanece como solução final. workshop/lab-01-v1-starter e workshop/lab-02-v1-starter são pontos de partida compiláveis; as branches versionadas workshop/*-step-* são checkpoints somente de leitura para comparação e recuperação.
📋 Pré-requisitos
- Node.js 20 ou superior;
- npm;
- Git;
- uma API key de projeto da OpenAI;
- navegador moderno;
- microfone e suporte a WebRTC para o Lab 02;
- fones de ouvido recomendados para reduzir eco no agente Realtime.
Confirme as ferramentas:
node --version
npm --version
git --version
🚀 Início rápido
Na primeira execução, siga o Módulo 00 — configuração do ambiente, da API e execução local. Ele explica como criar ou selecionar o projeto da API OpenAI, proteger a chave, validar /api/health e resolver erros comuns. A versão resumida está abaixo.
1. Clone o repositório
git clone https://github.com/glaucia86/openai-voice-playground.git
cd openai-voice-playground
2. Instale os dois laboratórios
npm run install:labs
Para instalar somente um:
npm ci --prefix labs/lab-01-text-to-speech
# ou
npm ci --prefix labs/lab-02-realtime-voice-agent
3. Configure o laboratório escolhido
macOS, Linux ou Git Bash:
cp labs/lab-01-text-to-speech/.env.example \
   labs/lab-01-text-to-speech/.env.local
PowerShell:
Copy-Item labs/lab-01-text-to-speech/.env.example `
  labs/lab-01-text-to-speech/.env.local
Abra o .env.local criado e adicione sua chave:
OPENAI_API_KEY=your_project_key
4. Inicie o laboratório
npm run dev:lab01
Abra http://localhost:3000. Para o agente Realtime, repita a configuração dentro de lab-02-realtime-voice-agent e execute:
npm run dev:lab02
▶️ Resumo de execução
Execute os comandos abaixo na raiz do repositório:
| Objetivo | Comando |
|---|---|
| Instalar todos os labs | npm run install:labs |
| Executar Lab 01 | npm run dev:lab01 |
| Executar Lab 02 | npm run dev:lab02 |
| Validar Lab 01 | npm run check:lab01 |
| Validar Lab 02 | npm run check:lab02 |
| Validar todo o repositório | npm run check |
Execute apenas um servidor por vez, a menos que defina portas diferentes explicitamente.
🔐 Variáveis de ambiente
Cada laboratório possui seu próprio .env.example:
# Obrigatória e somente no servidor
OPENAI_API_KEY=

# Obrigatória em produção; opcional somente no desenvolvimento local
PLAYGROUND_ACCESS_TOKEN=

# Obrigatória em produção
APP_ORIGIN=

# Obrigatórias em produção: quota compartilhada entre instâncias serverless
UPSTASH_REDIS_REST_URL=
UPSTASH_REDIS_REST_TOKEN=

# Obrigatória fora da Vercel; use um header sobrescrito pelo proxy confiável
CLIENT_IP_HEADER=
Regras inegociáveis:
- nunca faça commit de
.env,.env.localou arquivos baixados da Vercel; - nunca use
NEXT_PUBLIC_OPENAI_API_KEY; - nunca coloque uma chave real em
.env.example; - confirme a proteção com
git check-ignore -v caminho/.env.local; - use projetos, chaves, quotas e orçamentos separados por ambiente quando possível.
✅ Qualidade e CI/CD
O workflow .github/workflows/ci.yml executa uma matriz independente para os dois laboratórios em todo push para main e em pull requests:
npm ci
  ├── auditoria de dependências high/critical
  ├── lint com Oxlint
  ├── type-check com TypeScript 7
  ├── testes com cobertura
  └── build de produção com Next.js 15
O Dependabot mantém as dependências visíveis para revisão e o workflow CodeQL, com Actions fixadas por SHA, executa análise estática também de forma agendada.
Execute localmente antes de abrir um pull request:
npm run check
▲ Deploy na Vercel
Crie um projeto Vercel separado para cada laboratório e configure Root Directory:
| Projeto | Root Directory |
|---|---|
| Lab 01 — TTS | labs/lab-01-text-to-speech |
| Lab 02 — Realtime | labs/lab-02-realtime-voice-agent |
Depois:
- mantenha
maincomo Production Branch; - cadastre
OPENAI_API_KEYnas Environment Variables criptografadas; - adicione
PLAYGROUND_ACCESS_TOKEN— ele é obrigatório em produção; - configure
APP_ORIGINcom o domínio final; - conecte Upstash Redis com
UPSTASH_REDIS_REST_URLeUPSTASH_REDIS_REST_TOKEN; - na Vercel, deixe
CLIENT_IP_HEADERvazio para usarx-vercel-forwarded-for; fora dela, informe um header sobrescrito pelo seu proxy confiável; - valide
/api/healthsem expor credenciais; - no Lab 02, confirme HTTPS e permissão de microfone.
Se a configuração de segurança ou o limitador distribuído falhar em produção, a API retorna 503 e não inicia uma chamada faturável.
Os capítulos de deploy dos workshops documentam smoke tests e controles operacionais ainda necessários.
🛡️ Uso responsável
- Vozes sintéticas são identificadas como geradas por IA.
- Não use o projeto para imitar pessoas reais ou enganar ouvintes.
- Texto, instruções, áudio, transcripts e credenciais não pertencem aos logs.
- O Lab 02 mantém transcripts apenas na memória da página e não copia áudio para o histórico local.
- Client secrets efêmeros reduzem exposição, mas continuam sendo credenciais bearer.
- Em produção a quota é distribuída com Upstash Redis; apenas o desenvolvimento local usa fallback em memória.
- O Lab 02 encerra a sessão do workshop após 15 minutos no cliente. Como o WebRTC segue direto para a OpenAI, esse timer não é um limite autoritativo contra um cliente modificado.
- A aplicação não persiste conteúdo, mas logs de monitoramento de abuso do provedor podem ser retidos por até 30 dias nos controles padrão da API.
Antes de lançar um SaaS público, substitua o token compartilhado por identidade e autorização reais, adicione quota por usuário e sessões concorrentes, orçamentos e alertas do projeto OpenAI, consentimento, política de retenção revisada, observabilidade, resposta a abuso e aprovação humana para ferramentas com efeitos relevantes.
Leia SECURITY.md para conhecer a política de segurança.
🤝 Como contribuir
Contribuições que melhorem clareza, segurança, acessibilidade, testes ou valor educacional são bem-vindas.
- leia CONTRIBUTING.md e AGENTS.md;
- crie um fork e uma branch focada;
- atualize código e workshop juntos;
- execute
npm run check; - abra um pull request explicando decisão, trade-off e validação.
Se este projeto ajudou você, considere deixar uma ⭐. Isso ajuda outras pessoas a encontrar os laboratórios.
👩🏽💻 Sobre a autora

Glaucia Lemos
Principal Software Engineer · Forward Deployed Engineering Manager
Engenheira de software, educadora e criadora de conteúdo apaixonada por JavaScript, TypeScript, Node.js, Cloud, Inteligência Artificial e comunidades open source.




“Compartilhar conhecimento é multiplicar possibilidades.”
Feito com 💚, TypeScript e muita curiosidade por Glaucia Lemos.